
167 lines
15 KiB
Markdown
167 lines
15 KiB
Markdown
# 01 | CPU缓存:怎样写代码能够让CPU执行得更快?
|
||
|
||
你好,我是陶辉。
|
||
|
||
这是课程的第一讲,我们先从主机最重要的部件CPU开始,聊聊如何通过提升CPU缓存的命中率来优化程序的性能。
|
||
|
||
任何代码的执行都依赖CPU,通常,使用好CPU是操作系统内核的工作。然而,当我们编写计算密集型的程序时,CPU的执行效率就开始变得至关重要。由于CPU缓存由更快的SRAM构成(内存是由DRAM构成的),而且离CPU核心更近,如果运算时需要的输入数据是从CPU缓存,而不是内存中读取时,运算速度就会快很多。所以,了解CPU缓存对性能的影响,便能够更有效地编写我们的代码,优化程序性能。
|
||
|
||
然而,很多同学并不清楚CPU缓存的运行规则,不知道如何写代码才能够配合CPU缓存的工作方式,这样,便放弃了可以大幅提升核心计算代码执行速度的机会。而且,越是底层的优化,适用范围越广,CPU缓存便是如此,它的运行规则对分布式集群里各种操作系统、编程语言都有效。所以,一旦你能掌握它,集群中巨大的主机数量便能够放大优化效果。
|
||
|
||
接下来,我们就看看,CPU缓存结构到底是什么样的,又该如何优化它?
|
||
|
||
## CPU的多级缓存
|
||
|
||
刚刚我们提到,CPU缓存离CPU核心更近,由于电子信号传输是需要时间的,所以离CPU核心越近,缓存的读写速度就越快。但CPU的空间很狭小,离CPU越近缓存大小受到的限制也越大。所以,综合硬件布局、性能等因素,CPU缓存通常分为大小不等的三级缓存。
|
||
|
||
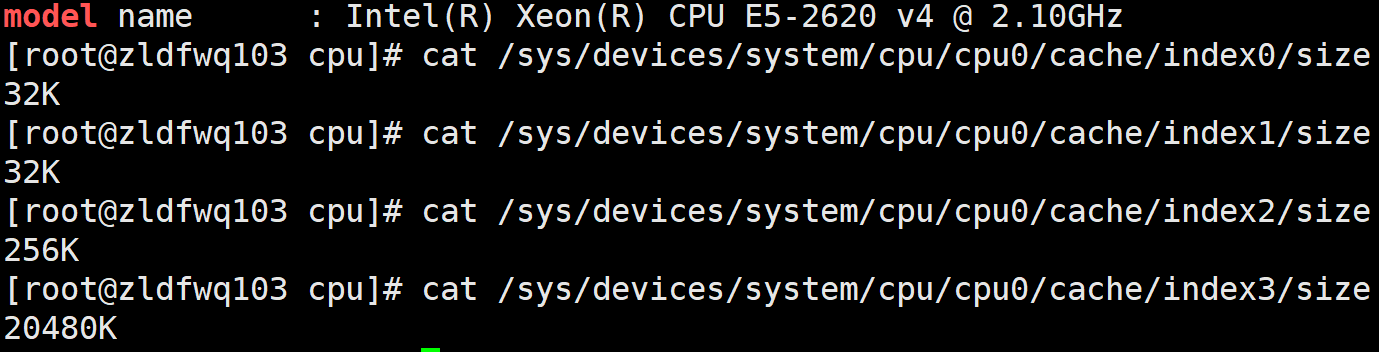
CPU缓存的材质SRAM比内存使用的DRAM贵许多,所以不同于内存动辄以GB计算,它的大小是以MB来计算的。比如,在我的Linux系统上,离CPU最近的一级缓存是32KB,二级缓存是256KB,最大的三级缓存则是20MB(Windows系统查看缓存大小可以用wmic cpu指令,或者用[CPU-Z](https://www.cpuid.com/softwares/cpu-z.html)这个工具)。
|
||
|
||
|
||
|
||
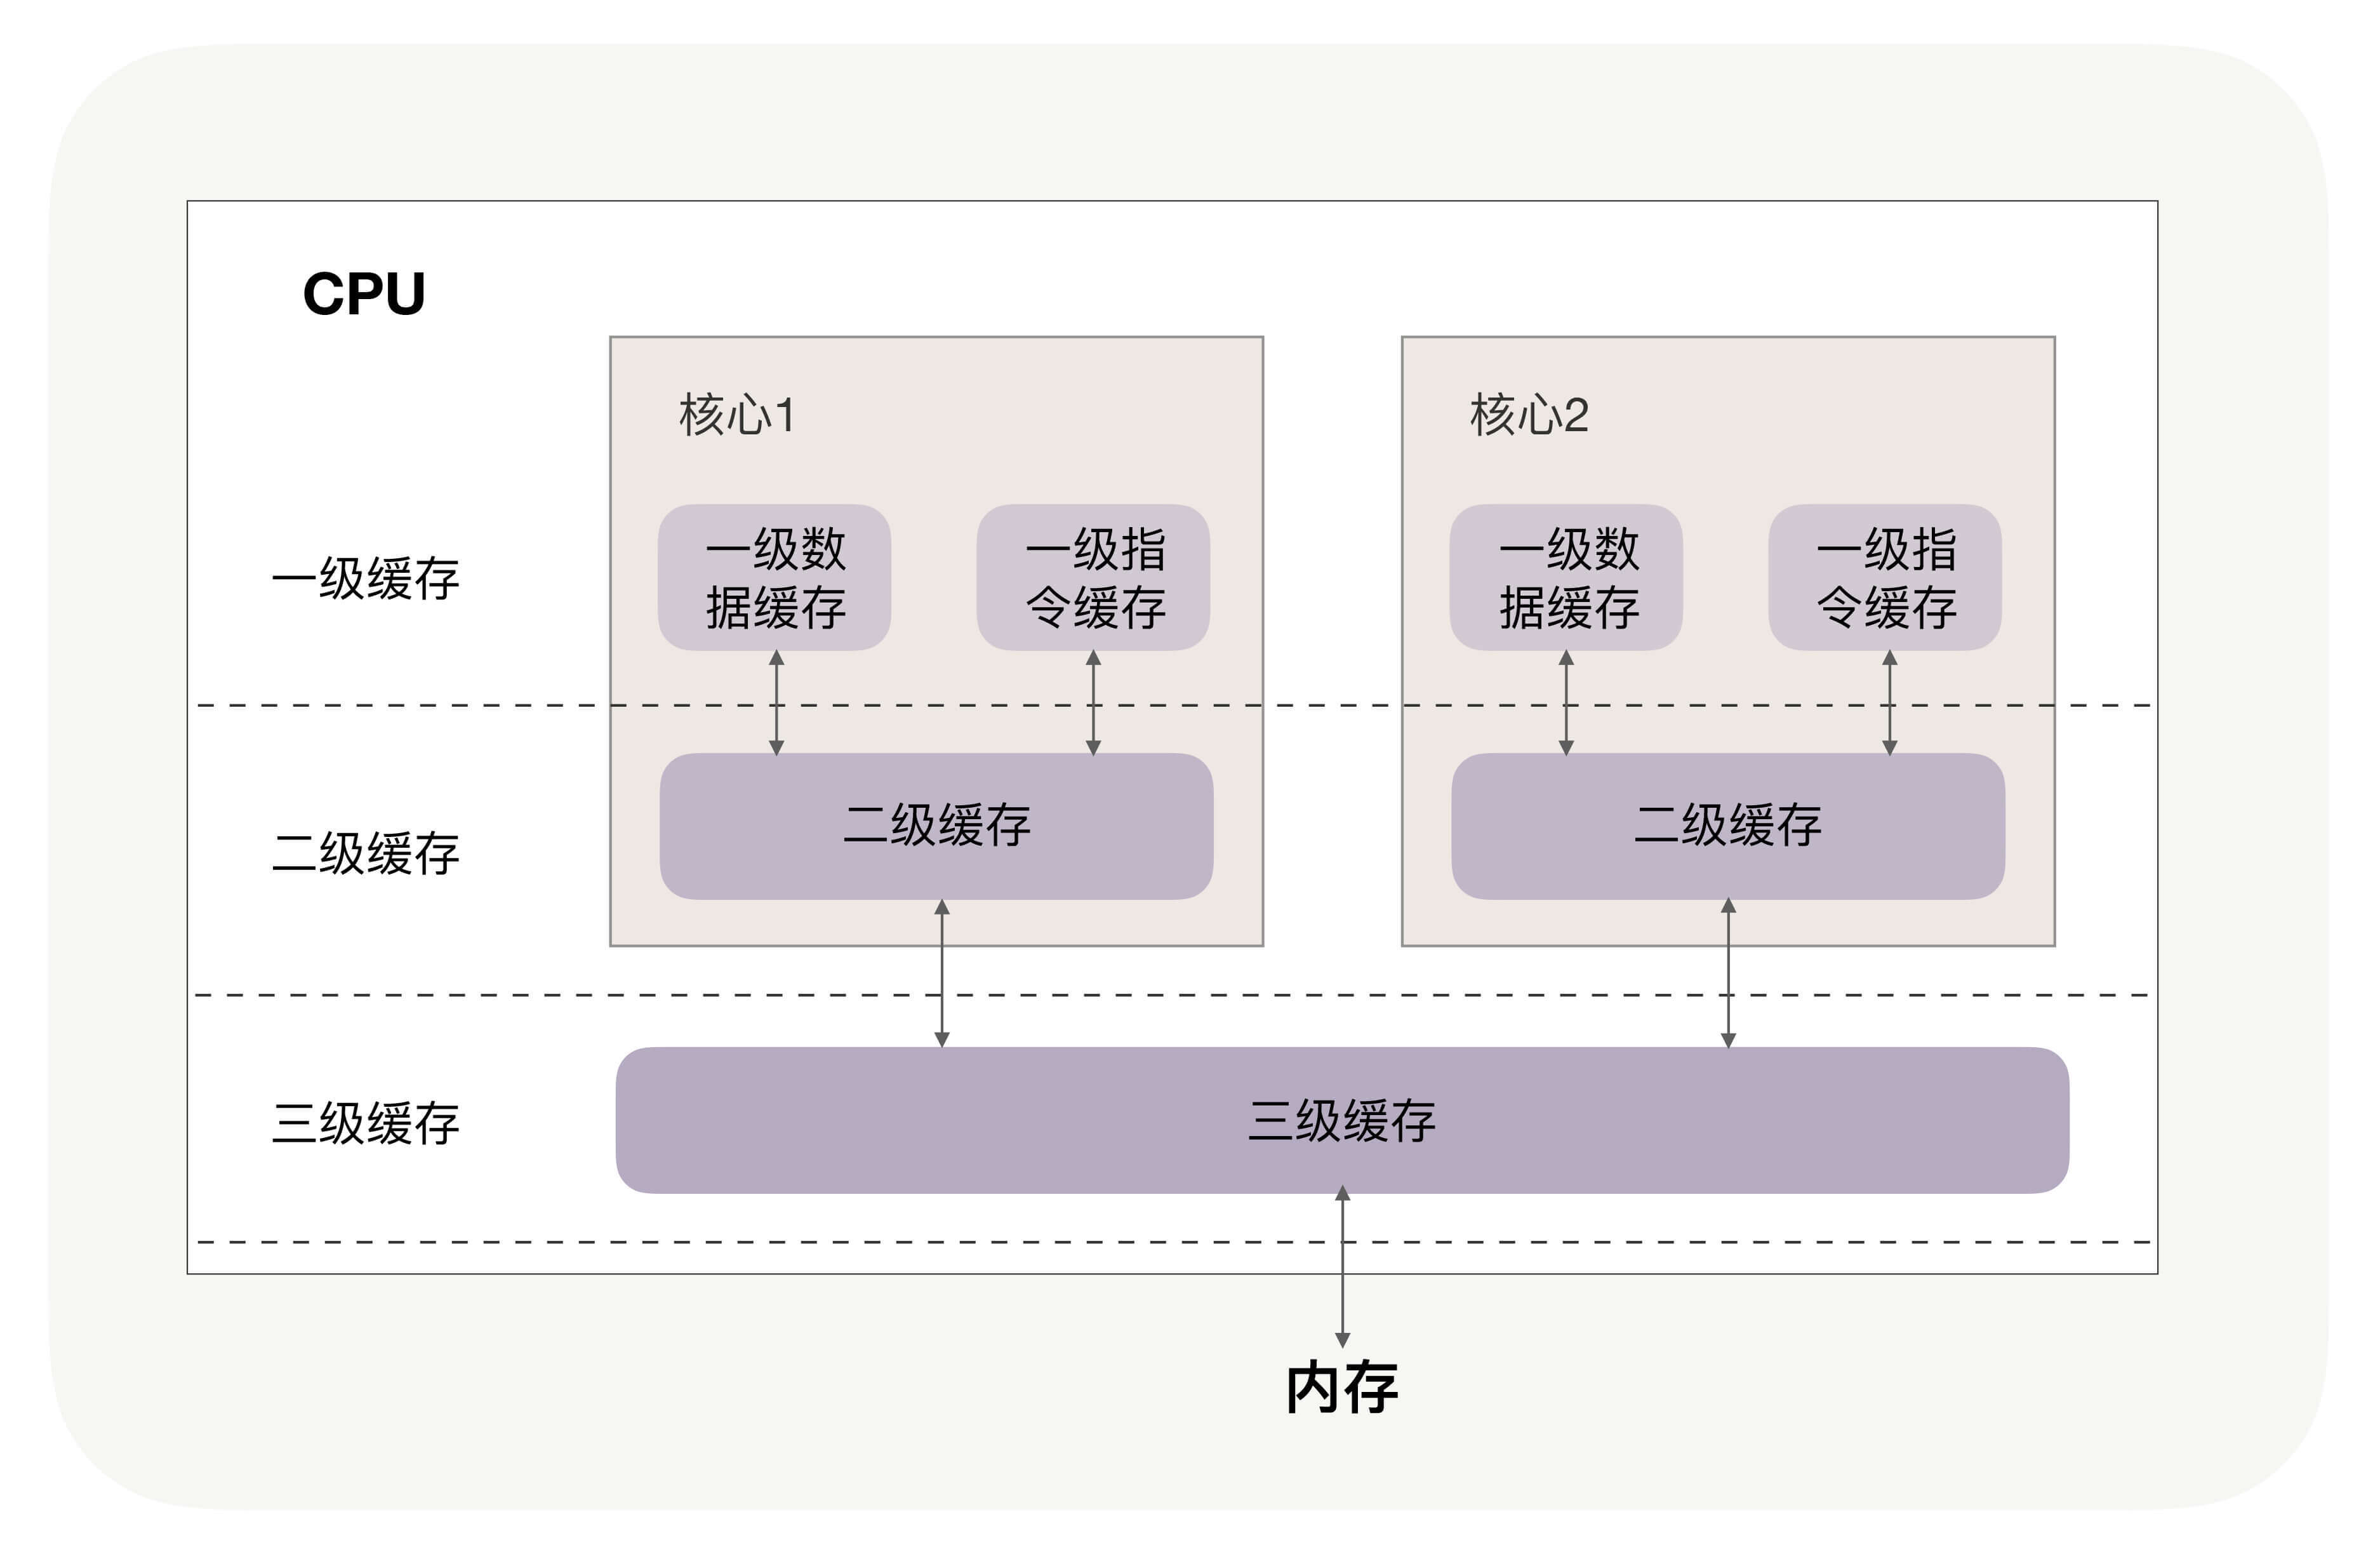
你可能注意到,三级缓存要比一、二级缓存大许多倍,这是因为当下的CPU都是多核心的,每个核心都有自己的一、二级缓存,但三级缓存却是一颗CPU上所有核心共享的。
|
||
|
||
程序执行时,会先将内存中的数据载入到共享的三级缓存中,再进入每颗核心独有的二级缓存,最后进入最快的一级缓存,之后才会被CPU使用,就像下面这张图。
|
||
|
||
|
||
|
||
缓存要比内存快很多。CPU访问一次内存通常需要100个时钟周期以上,而访问一级缓存只需要4~5个时钟周期,二级缓存大约12个时钟周期,三级缓存大约30个时钟周期(对于2GHZ主频的CPU来说,一个时钟周期是0.5纳秒。你可以在LZMA的[Benchmark](https://www.7-cpu.com/)中找到几种典型CPU缓存的访问速度)。
|
||
|
||
如果CPU所要操作的数据在缓存中,则直接读取,这称为缓存命中。命中缓存会带来很大的性能提升,**因此,我们的代码优化目标是提升CPU缓存的命中率。**
|
||
|
||
当然,缓存命中率是很笼统的,具体优化时还得一分为二。比如,你在查看CPU缓存时会发现有2个一级缓存(比如Linux上就是上图中的index0和index1),这是因为,CPU会区别对待指令与数据。比如,“1+1=2”这个运算,“+”就是指令,会放在一级指令缓存中,而“1”这个输入数字,则放在一级数据缓存中。虽然在冯诺依曼计算机体系结构中,代码指令与数据是放在一起的,但执行时却是分开进入指令缓存与数据缓存的,因此我们要分开来看二者的缓存命中率。
|
||
|
||
## 提升数据缓存的命中率
|
||
|
||
我们先来看数据的访问顺序是如何影响缓存命中率的。
|
||
|
||
比如现在要遍历二维数组,其定义如下(这里我用的是伪代码,在GitHub上我为你准备了可运行验证的C/C++、Java[示例代码](https://github.com/russelltao/geektime_distrib_perf/tree/master/1-cpu_cache/traverse_2d_array),你可以参照它们编写出其他语言的可执行代码):
|
||
|
||
```
|
||
int array[N][N];
|
||
|
||
```
|
||
|
||
你可以思考一下,用array\[j\]\[i\]和array\[i\]\[j\]访问数组元素,哪一种性能更快?
|
||
|
||
```
|
||
for(i = 0; i < N; i+=1) {
|
||
for(j = 0; j < N; j+=1) {
|
||
array[i][j] = 0;
|
||
}
|
||
}
|
||
|
||
```
|
||
|
||
在我给出的GitHub地址上的C++代码实现中,前者array\[j\]\[i\]执行的时间是后者array\[i\]\[j\]的8倍之多(请参考[traverse\_2d\_array.cpp](https://github.com/russelltao/geektime_distrib_perf/tree/master/1-cpu_cache/traverse_2d_array),如果使用Python代码,traverse\_2d\_array.py由于数组容器的差异,性能差距不会那么大)。
|
||
|
||
为什么会有这么大的差距呢?这是因为二维数组array所占用的内存是连续的,比如若长度N的值为2,那么内存中从前至后各元素的顺序是:
|
||
|
||
```
|
||
array[0][0],array[0][1],array[1][0],array[1][1]。
|
||
|
||
```
|
||
|
||
如果用array\[i\]\[j\]访问数组元素,则完全与上述内存中元素顺序一致,因此访问array\[0\]\[0\]时,缓存已经把紧随其后的3个元素也载入了,CPU通过快速的缓存来读取后续3个元素就可以。如果用array\[j\]\[i\]来访问,访问的顺序就是:
|
||
|
||
```
|
||
array[0][0],array[1][0],array[0][1],array[1][1]
|
||
|
||
```
|
||
|
||
此时内存是跳跃访问的,如果N的数值很大,那么操作array\[j\]\[i\]时,是没有办法把array\[j+1\]\[i\]也读入缓存的。
|
||
|
||
到这里我们还有2个问题没有搞明白:
|
||
|
||
1. 为什么两者的执行时间有约7、8倍的差距呢?
|
||
2. 载入array\[0\]\[0\]元素时,缓存一次性会载入多少元素呢?
|
||
|
||
其实这两个问题的答案都与CPU Cache Line相关,它定义了缓存一次载入数据的大小,Linux上你可以通过coherency\_line\_size配置查看它,通常是64字节。
|
||
|
||

|
||
|
||
因此,我测试的服务器一次会载入64字节至缓存中。当载入array\[0\]\[0\]时,若它们占用的内存不足64字节,CPU就会顺序地补足后续元素。顺序访问的array\[i\]\[j\]因为利用了这一特点,所以就会比array\[j\]\[i\]要快。也正因为这样,当元素类型是4个字节的整数时,性能就会比8个字节的高精度浮点数时速度更快,因为缓存一次载入的元素会更多。
|
||
|
||
**因此,遇到这种遍历访问数组的情况时,按照内存布局顺序访问将会带来很大的性能提升。**
|
||
|
||
再来看为什么执行时间相差8倍。在二维数组中,其实第一维元素存放的是地址,第二维存放的才是目标元素。由于64位操作系统的地址占用8个字节(32位操作系统是4个字节),因此,每批Cache Line最多也就能载入不到8个二维数组元素,所以性能差距大约接近8倍。(用不同的步长访问数组,也能验证CPU Cache Line对性能的影响,可参考我给你准备的[Github](https://github.com/russelltao/geektime_distrib_perf/tree/master/1-cpu_cache/traverse_1d_array)上的测试代码)。
|
||
|
||
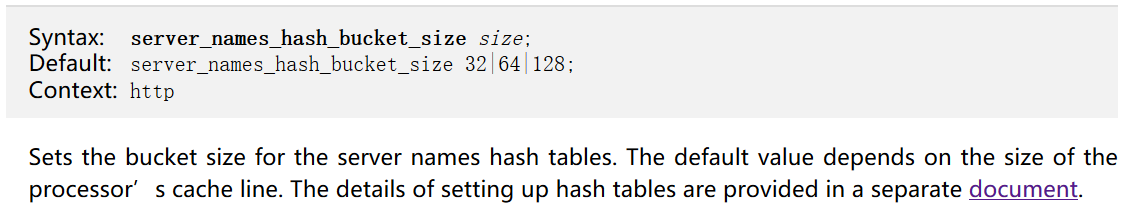
关于CPU Cache Line的应用其实非常广泛,如果你用过Nginx,会发现它是用哈希表来存放域名、HTTP头部等数据的,这样访问速度非常快,而哈希表里桶的大小如server\_names\_hash\_bucket\_size,它默认就等于CPU Cache Line的值。由于所存放的字符串长度不能大于桶的大小,所以当需要存放更长的字符串时,就需要修改桶大小,但Nginx官网上明确建议它应该是CPU Cache Line的整数倍。
|
||
|
||
|
||
|
||
为什么要做这样的要求呢?就是因为按照cpu cache line(比如64字节)来访问内存时,不会出现多核CPU下的伪共享问题,可以**尽量减少访问内存的次数**。比如,若桶大小为64字节,那么根据地址获取字符串时只需要访问一次内存,而桶大小为50字节,会导致最坏2次访问内存,而70字节最坏会有3次访问内存。
|
||
|
||
如果你在用Linux操作系统,可以通过一个名叫Perf的工具直观地验证缓存命中的情况(可以用yum install perf或者apt-get install perf安装这个工具,这个[网址](http://www.brendangregg.com/perf.html)中有大量案例可供参考)。
|
||
|
||
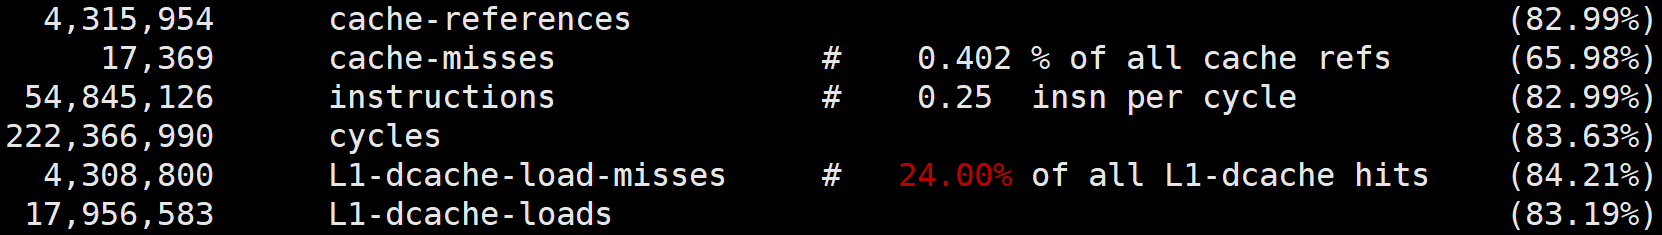
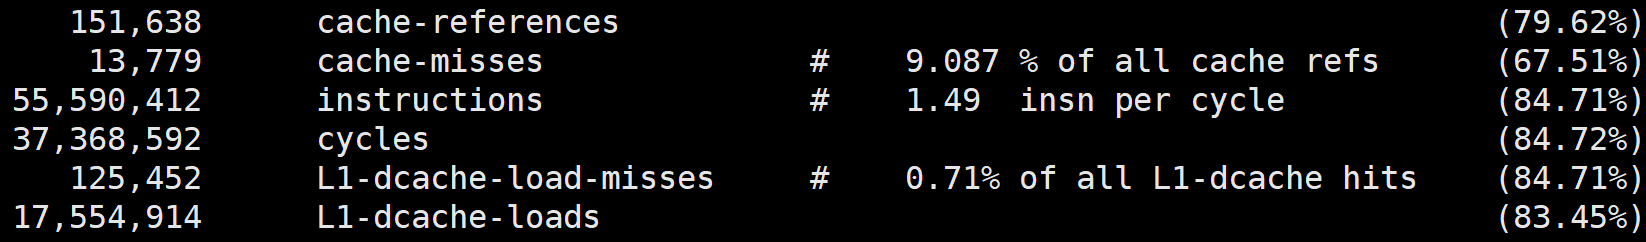
执行perf stat可以统计出进程运行时的系统信息(通过-e选项指定要统计的事件,如果要查看三级缓存总的命中率,可以指定缓存未命中cache-misses事件,以及读取缓存次数cache-references事件,两者相除就是缓存的未命中率,用1相减就是命中率。类似的,通过L1-dcache-load-misses和L1-dcache-loads可以得到L1缓存的命中率),此时你会发现array\[i\]\[j\]的缓存命中率远高于array\[j\]\[i\]。
|
||
|
||
当然,perf stat还可以通过指令执行速度反映出两种访问方式的优劣,如下图所示(instructions事件指明了进程执行的总指令数,而cycles事件指明了运行的时钟周期,二者相除就可以得到每时钟周期所执行的指令数,缩写为IPC。如果缓存未命中,则CPU要等待内存的慢速读取,因此IPC就会很低。array\[i\]\[j\]的IPC值也比array\[j\]\[i\]要高得多):
|
||
|
||
|
||
|
||
|
||
## 提升指令缓存的命中率
|
||
|
||
说完数据的缓存命中率,再来看指令的缓存命中率该如何提升。
|
||
|
||
我们还是用一个例子来看一下。比如,有一个元素为0到255之间随机数字组成的数组:
|
||
|
||
```
|
||
int array[N];
|
||
for (i = 0; i < TESTN; i++) array[i] = rand() % 256;
|
||
|
||
```
|
||
|
||
接下来要对它做两个操作:一是循环遍历数组,判断每个数字是否小于128,如果小于则把元素的值置为0;二是将数组排序。那么,先排序再遍历速度快,还是先遍历再排序速度快呢?
|
||
|
||
```
|
||
for(i = 0; i < N; i++) {
|
||
if (array [i] < 128) array[i] = 0;
|
||
}
|
||
sort(array, array +N);
|
||
|
||
```
|
||
|
||
我先给出答案:先排序的遍历时间只有后排序的三分之一(参考GitHub中的[branch\_predict.cpp代码](https://github.com/russelltao/geektime_distrib_perf/tree/master/1-cpu_cache/branch_predict))。为什么会这样呢?这是因为循环中有大量的if条件分支,而CPU**含有分支预测器**。
|
||
|
||
当代码中出现if、switch等语句时,意味着此时至少可以选择跳转到两段不同的指令去执行。如果分支预测器可以预测接下来要在哪段代码执行(比如if还是else中的指令),就可以提前把这些指令放在缓存中,CPU执行时就会很快。当数组中的元素完全随机时,分支预测器无法有效工作,而当array数组有序时,分支预测器会动态地根据历史命中数据对未来进行预测,命中率就会非常高。
|
||
|
||
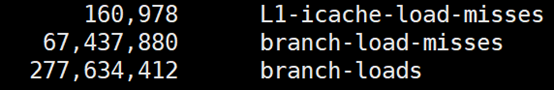
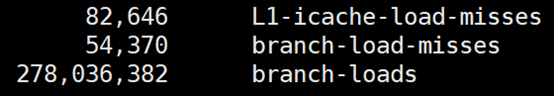
究竟有多高呢?我们还是用Linux上的perf来做个验证。使用 -e选项指明branch-loads事件和branch-load-misses事件,它们分别表示分支预测的次数,以及预测失败的次数。通过L1-icache-load-misses也能查看到一级缓存中指令的未命中情况。
|
||
|
||
下图是我在GitHub上为你准备的验证程序执行的perf分支预测统计数据(代码见[这里](https://github.com/russelltao/geektime_distrib_perf/tree/master/1-cpu_cache/branch_predict)),你可以看到,先排序的话分支预测的成功率非常高,而且一级指令缓存的未命中率也有大幅下降。
|
||
|
||
|
||
|
||
|
||
|
||
C/C++语言中编译器还给应用程序员提供了显式预测分支概率的工具,如果if中的条件表达式判断为“真”的概率非常高,我们可以用likely宏把它括在里面,反之则可以用unlikely宏。当然,CPU自身的条件预测已经非常准了,仅当我们确信CPU条件预测不会准,且我们能够知晓实际概率时,才需要加入这两个宏。
|
||
|
||
```
|
||
#define likely(x) __builtin_expect(!!(x), 1)
|
||
#define unlikely(x) __builtin_expect(!!(x), 0)
|
||
if (likely(a == 1)) …
|
||
|
||
```
|
||
|
||
## 提升多核CPU下的缓存命中率
|
||
|
||
前面我们都是面向一个CPU核心谈数据及指令缓存的,然而现代CPU几乎都是多核的。虽然三级缓存面向所有核心,但一、二级缓存是每颗核心独享的。我们知道,即使只有一个CPU核心,现代分时操作系统都支持许多进程同时运行。这是因为操作系统把时间切成了许多片,微观上各进程按时间片交替地占用CPU,这造成宏观上看起来各程序同时在执行。
|
||
|
||
因此,若进程A在时间片1里使用CPU核心1,自然也填满了核心1的一、二级缓存,当时间片1结束后,操作系统会让进程A让出CPU,基于效率并兼顾公平的策略重新调度CPU核心1,以防止某些进程饿死。如果此时CPU核心1繁忙,而CPU核心2空闲,则进程A很可能会被调度到CPU核心2上运行,这样,即使我们对代码优化得再好,也只能在一个时间片内高效地使用CPU一、二级缓存了,下一个时间片便面临着缓存效率的问题。
|
||
|
||
因此,操作系统提供了将进程或者线程绑定到某一颗CPU上运行的能力。如Linux上提供了sched\_setaffinity方法实现这一功能,其他操作系统也有类似功能的API可用。我在GitHub上提供了一个示例程序(代码见[这里](https://github.com/russelltao/geektime_distrib_perf/tree/master/1-cpu_cache/cpu_migrate)),你可以看到,当多线程同时执行密集计算,且CPU缓存命中率很高时,如果将每个线程分别绑定在不同的CPU核心上,性能便会获得非常可观的提升。Perf工具也提供了cpu-migrations事件,它可以显示进程从不同的CPU核心上迁移的次数。
|
||
|
||
## 小结
|
||
|
||
今天我给你介绍了CPU缓存对程序性能的影响。这是很底层的性能优化,它对各种编程语言做密集计算时都有效。
|
||
|
||
CPU缓存分为数据缓存与指令缓存,对于数据缓存,我们应在循环体中尽量操作同一块内存上的数据,由于缓存是根据CPU Cache Line批量操作数据的,所以顺序地操作连续内存数据时也有性能提升。
|
||
|
||
对于指令缓存,有规律的条件分支能够让CPU的分支预测发挥作用,进一步提升执行效率。对于多核系统,如果进程的缓存命中率非常高,则可以考虑绑定CPU来提升缓存命中率。
|
||
|
||
## 思考题
|
||
|
||
最后请你思考下,多线程并行访问不同的变量,这些变量在内存布局是相邻的(比如类中的多个变量),此时CPU缓存就会失效,为什么?又该如何解决呢?欢迎你在留言区与大家一起探讨。
|
||
|
||
感谢阅读,如果你觉得这节课对你有一些启发,也欢迎把它分享给你的朋友。
|
||
|