
167 lines
13 KiB
Markdown
167 lines
13 KiB
Markdown
# 22 | 想成为架构师,你必须知道CAP理论
|
||
|
||
CAP定理(CAP theorem)又被称作布鲁尔定理(Brewer's theorem),是加州大学伯克利分校的计算机科学家埃里克·布鲁尔(Eric Brewer)在2000年的ACM PODC上提出的一个猜想。2002年,麻省理工学院的赛斯·吉尔伯特(Seth Gilbert)和南希·林奇(Nancy Lynch)发表了布鲁尔猜想的证明,使之成为分布式计算领域公认的一个定理。对于设计分布式系统的架构师来说,CAP是必须掌握的理论。
|
||
|
||
布鲁尔在提出CAP猜想的时候,并没有详细定义Consistency、Availability、Partition Tolerance三个单词的明确定义,因此如果初学者去查询CAP定义的时候会感到比较困惑,因为不同的资料对CAP的详细定义有一些细微的差别,例如:
|
||
|
||
> **Consistency**: where all nodes see the same data at the same time.
|
||
>
|
||
> **Availability**: which guarantees that every request receives a response about whether it succeeded or failed.
|
||
>
|
||
> **Partition tolerance**: where the system continues to operate even if any one part of the system is lost or fails.
|
||
|
||
([https://console.bluemix.net/docs/services/Cloudant/guides/cap\_theorem.html#cap-](https://console.bluemix.net/docs/services/Cloudant/guides/cap_theorem.html#cap-))
|
||
|
||
> **Consistency**: Every read receives the most recent write or an error.
|
||
>
|
||
> **Availability**: Every request receives a (non-error) response – without guarantee that it contains the most recent write.
|
||
>
|
||
> **Partition tolerance**: The system continues to operate despite an arbitrary number of messages being dropped (or delayed) by the network between nodes.
|
||
|
||
([https://en.wikipedia.org/wiki/CAP\_theorem#cite\_note-Brewer2012-6](https://en.wikipedia.org/wiki/CAP_theorem#cite_note-Brewer2012-6))
|
||
|
||
> **Consistency**: all nodes have access to the same data simultaneously.
|
||
>
|
||
> **Availability**: a promise that every request receives a response, at minimum whether the request succeeded or failed.
|
||
>
|
||
> **Partition tolerance**: the system will continue to work even if some arbitrary node goes offline or can’t communicate.
|
||
|
||
([https://www.teamsilverback.com/understanding-the-cap-theorem/](https://www.teamsilverback.com/understanding-the-cap-theorem/))
|
||
|
||
为了更好地解释CAP理论,我挑选了Robert Greiner([http://robertgreiner.com/about/](http://robertgreiner.com/about/))的文章作为参考基础。有趣的是,Robert Greiner对CAP的理解也经历了一个过程,他写了两篇文章来阐述CAP理论,第一篇被标记为“outdated”(有一些中文翻译文章正好参考了第一篇),我将对比前后两篇解释的差异点,通过对比帮助你更加深入地理解CAP理论。
|
||
|
||
## CAP理论
|
||
|
||
第一版解释:
|
||
|
||
> Any distributed system cannot guaranty C, A, and P simultaneously.
|
||
|
||
([http://robertgreiner.com/2014/06/cap-theorem-explained/](http://robertgreiner.com/2014/06/cap-theorem-explained/))
|
||
|
||
简单翻译为:对于一个分布式计算系统,不可能同时满足一致性(Consistence)、可用性(Availability)、分区容错性(Partition Tolerance)三个设计约束。
|
||
|
||
第二版解释:
|
||
|
||
> In a distributed system (a collection of interconnected nodes that share data.), you can only have two out of the following three guarantees across a write/read pair: Consistency, Availability, and Partition Tolerance - one of them must be sacrificed.
|
||
|
||
([http://robertgreiner.com/2014/08/cap-theorem-revisited/](http://robertgreiner.com/2014/08/cap-theorem-revisited/))
|
||
|
||
简单翻译为:在一个分布式系统(指互相连接并共享数据的节点的集合)中,当涉及读写操作时,只能保证一致性(Consistence)、可用性(Availability)、分区容错性(Partition Tolerance)三者中的两个,另外一个必须被牺牲。
|
||
|
||
对比两个版本的定义,有几个很关键的差异点:
|
||
|
||
* 第二版定义了什么才是CAP理论探讨的分布式系统,强调了两点:interconnected和share data,为何要强调这两点呢? 因为**分布式系统并不一定会互联和共享数据**。最简单的例如Memcache的集群,相互之间就没有连接和共享数据,因此Memcache集群这类分布式系统就不符合CAP理论探讨的对象;而MySQL集群就是互联和进行数据复制的,因此是CAP理论探讨的对象。
|
||
|
||
* 第二版强调了write/read pair,这点其实是和上一个差异点一脉相承的。也就是说,**CAP关注的是对数据的读写操作,而不是分布式系统的所有功能**。例如,ZooKeeper的选举机制就不是CAP探讨的对象。
|
||
|
||
|
||
相比来说,第二版的定义更加精确。
|
||
|
||
虽然第二版的定义和解释更加严谨,但内容相比第一版来说更加难记一些,所以现在大部分技术人员谈论CAP理论时,更多还是按照第一版的定义和解释来说的,因为第一版虽然不严谨,但非常简单和容易记住。
|
||
|
||
第二版除了基本概念,三个基本的设计约束也进行了重新阐述,我来详细分析一下。
|
||
|
||
1.一致性(Consistency)
|
||
|
||
第一版解释:
|
||
|
||
> All nodes see the same data at the same time.
|
||
|
||
简单翻译为:所有节点在同一时刻都能看到相同的数据。
|
||
|
||
第二版解释:
|
||
|
||
> A read is guaranteed to return the most recent write for a given client.
|
||
|
||
简单翻译为:对某个指定的客户端来说,读操作保证能够返回最新的写操作结果。
|
||
|
||
第一版解释和第二版解释的主要差异点表现在:
|
||
|
||
* 第一版从节点node的角度描述,第二版从客户端client的角度描述。
|
||
|
||
相比来说,第二版更加符合我们观察和评估系统的方式,即站在客户端的角度来观察系统的行为和特征。
|
||
|
||
* 第一版的关键词是see,第二版的关键词是read。
|
||
|
||
第一版解释中的see,其实并不确切,因为节点node是拥有数据,而不是看到数据,即使要描述也是用have;第二版从客户端client的读写角度来描述一致性,定义更加精确。
|
||
|
||
* 第一版强调同一时刻拥有相同数据(same time + same data),第二版并没有强调这点。
|
||
|
||
这就意味着实际上对于节点来说,可能同一时刻拥有不同数据(same time + different data),这和我们通常理解的一致性是有差异的,为何做这样的改动呢?其实在第一版的详细解释中已经提到了,具体内容如下:
|
||
|
||
> A system has consistency if a transaction starts with the system in a consistent state, and ends with the system in a consistent state. In this model, a system can (and does) shift into an inconsistent state during a transaction, but the entire transaction gets rolled back if there is an error during any stage in the process.
|
||
|
||
参考上述的解释,对于系统执行事务来说,**在事务执行过程中,系统其实处于一个不一致的状态,不同的节点的数据并不完全一致**,因此第一版的解释“All nodes see the same data at the same time”是不严谨的。而第二版强调client读操作能够获取最新的写结果就没有问题,因为事务在执行过程中,client是无法读取到未提交的数据的,只有等到事务提交后,client才能读取到事务写入的数据,而如果事务失败则会进行回滚,client也不会读取到事务中间写入的数据。
|
||
|
||
2.可用性(Availability)
|
||
|
||
第一版解释:
|
||
|
||
> Every request gets a response on success/failure.
|
||
|
||
简单翻译为:每个请求都能得到成功或者失败的响应。
|
||
|
||
第二版解释:
|
||
|
||
> A non-failing node will return a reasonable response within a reasonable amount of time (no error or timeout).
|
||
|
||
简单翻译为:非故障的节点在合理的时间内返回合理的响应(不是错误和超时的响应)。
|
||
|
||
第一版解释和第二版解释主要差异点表现在:
|
||
|
||
* 第一版是every request,第二版强调了A non-failing node。
|
||
|
||
第一版的every request是不严谨的,因为只有非故障节点才能满足可用性要求,如果节点本身就故障了,发给节点的请求不一定能得到一个响应。
|
||
|
||
* 第一版的response分为success和failure,第二版用了两个reasonable:reasonable response 和reasonable time,而且特别强调了no error or timeout。
|
||
|
||
第一版的success/failure的定义太泛了,几乎任何情况,无论是否符合CAP理论,我们都可以说请求成功和失败,因为超时也算失败、错误也算失败、异常也算失败、结果不正确也算失败;即使是成功的响应,也不一定是正确的。例如,本来应该返回100,但实际上返回了90,这就是成功的响应,但并没有得到正确的结果。相比之下,第二版的解释明确了不能超时、不能出错,结果是合理的,**注意没有说“正确”的结果**。例如,应该返回100但实际上返回了90,肯定是不正确的结果,但可以是一个合理的结果。
|
||
|
||
3.分区容忍性(Partition Tolerance)
|
||
|
||
第一版解释:
|
||
|
||
> System continues to work despite message loss or partial failure.
|
||
|
||
简单翻译为:出现消息丢失或者分区错误时系统能够继续运行。
|
||
|
||
第二版解释:
|
||
|
||
> The system will continue to function when network partitions occur.
|
||
|
||
简单翻译为:当出现网络分区后,系统能够继续“履行职责”。
|
||
|
||
第一版解释和第二版解释主要差异点表现在:
|
||
|
||
* 第一版用的是work,第二版用的是function。
|
||
|
||
work强调“运行”,只要系统不宕机,我们都可以说系统在work,返回错误也是work,拒绝服务也是work;而function强调“发挥作用”“履行职责”,这点和可用性是一脉相承的。也就是说,只有返回reasonable response才是function。相比之下,第二版解释更加明确。
|
||
|
||
* 第一版描述分区用的是message loss or partial failure,第二版直接用network partitions。
|
||
|
||
对比两版解释,第一版是直接说原因,即message loss造成了分区,但message loss的定义有点狭隘,因为通常我们说的message loss(丢包),只是网络故障中的一种;第二版直接说现象,即发生了**分区现象**,不管是什么原因,可能是丢包,也可能是连接中断,还可能是拥塞,只要导致了网络分区,就通通算在里面。
|
||
|
||
## CAP应用
|
||
|
||
虽然CAP理论定义是三个要素中只能取两个,但放到分布式环境下来思考,我们会发现必须选择P(分区容忍)要素,因为网络本身无法做到100%可靠,有可能出故障,所以分区是一个必然的现象。如果我们选择了CA而放弃了P,那么当发生分区现象时,为了保证C,系统需要禁止写入,当有写入请求时,系统返回error(例如,当前系统不允许写入),这又和A冲突了,因为A要求返回no error和no timeout。因此,分布式系统理论上不可能选择CA架构,只能选择CP或者AP架构。
|
||
|
||
1.CP - Consistency/Partition Tolerance
|
||
|
||
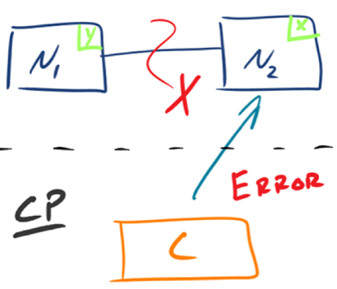
如下图所示,为了保证一致性,当发生分区现象后,N1节点上的数据已经更新到y,但由于N1和N2之间的复制通道中断,数据y无法同步到N2,N2节点上的数据还是x。这时客户端C访问N2时,N2需要返回Error,提示客户端C“系统现在发生了错误”,这种处理方式违背了可用性(Availability)的要求,因此CAP三者只能满足CP。
|
||
|
||
|
||
|
||
2.AP - Availability/Partition Tolerance
|
||
|
||
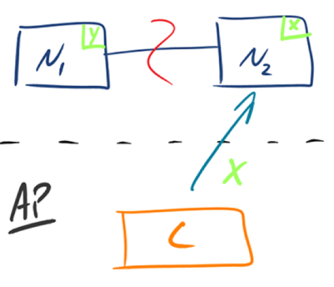
如下图所示,为了保证可用性,当发生分区现象后,N1节点上的数据已经更新到y,但由于N1和N2之间的复制通道中断,数据y无法同步到N2,N2节点上的数据还是x。这时客户端C访问N2时,N2将当前自己拥有的数据x返回给客户端C了,而实际上当前最新的数据已经是y了,这就不满足一致性(Consistency)的要求了,因此CAP三者只能满足AP。注意:这里N2节点返回x,虽然不是一个“正确”的结果,但是一个“合理”的结果,因为x是旧的数据,并不是一个错乱的值,只是不是最新的数据而已。
|
||
|
||
|
||
|
||
## 小结
|
||
|
||
今天我为你讲了CAP理论,通过对比两个不同版本的CAP理论解释,详细地分析了CAP理论的准确定义,希望对你有所帮助。
|
||
|
||
这就是今天的全部内容,留一道思考题给你吧,基于Paxos算法构建的分布式系统,属于CAP架构中的哪一种?谈谈你的分析和理解。
|
||
|
||
欢迎你把答案写到留言区,和我一起讨论。相信经过深度思考的回答,也会让你对知识的理解更加深刻。(编辑乱入:精彩的留言有机会获得丰厚福利哦!)
|
||
|