
312 lines
16 KiB
Markdown
312 lines
16 KiB
Markdown
# 35 | join语句怎么优化?
|
||
|
||
在上一篇文章中,我和你介绍了join语句的两种算法,分别是Index Nested-Loop Join(NLJ)和Block Nested-Loop Join(BNL)。
|
||
|
||
我们发现在使用NLJ算法的时候,其实效果还是不错的,比通过应用层拆分成多个语句然后再拼接查询结果更方便,而且性能也不会差。
|
||
|
||
但是,BNL算法在大表join的时候性能就差多了,比较次数等于两个表参与join的行数的乘积,很消耗CPU资源。
|
||
|
||
当然了,这两个算法都还有继续优化的空间,我们今天就来聊聊这个话题。
|
||
|
||
为了便于分析,我还是创建两个表t1、t2来和你展开今天的问题。
|
||
|
||
```
|
||
create table t1(id int primary key, a int, b int, index(a));
|
||
create table t2 like t1;
|
||
drop procedure idata;
|
||
delimiter ;;
|
||
create procedure idata()
|
||
begin
|
||
declare i int;
|
||
set i=1;
|
||
while(i<=1000)do
|
||
insert into t1 values(i, 1001-i, i);
|
||
set i=i+1;
|
||
end while;
|
||
|
||
set i=1;
|
||
while(i<=1000000)do
|
||
insert into t2 values(i, i, i);
|
||
set i=i+1;
|
||
end while;
|
||
|
||
end;;
|
||
delimiter ;
|
||
call idata();
|
||
|
||
```
|
||
|
||
为了便于后面量化说明,我在表t1里,插入了1000行数据,每一行的a=1001-id的值。也就是说,表t1中字段a是逆序的。同时,我在表t2中插入了100万行数据。
|
||
|
||
# Multi-Range Read优化
|
||
|
||
在介绍join语句的优化方案之前,我需要先和你介绍一个知识点,即:Multi-Range Read优化(MRR)。这个优化的主要目的是尽量使用顺序读盘。
|
||
|
||
在[第4篇文章](https://time.geekbang.org/column/article/69236)中,我和你介绍InnoDB的索引结构时,提到了“回表”的概念。我们先来回顾一下这个概念。回表是指,InnoDB在普通索引a上查到主键id的值后,再根据一个个主键id的值到主键索引上去查整行数据的过程。
|
||
|
||
然后,有同学在留言区问到,回表过程是一行行地查数据,还是批量地查数据?
|
||
|
||
我们先来看看这个问题。假设,我执行这个语句:
|
||
|
||
```
|
||
select * from t1 where a>=1 and a<=100;
|
||
|
||
```
|
||
|
||
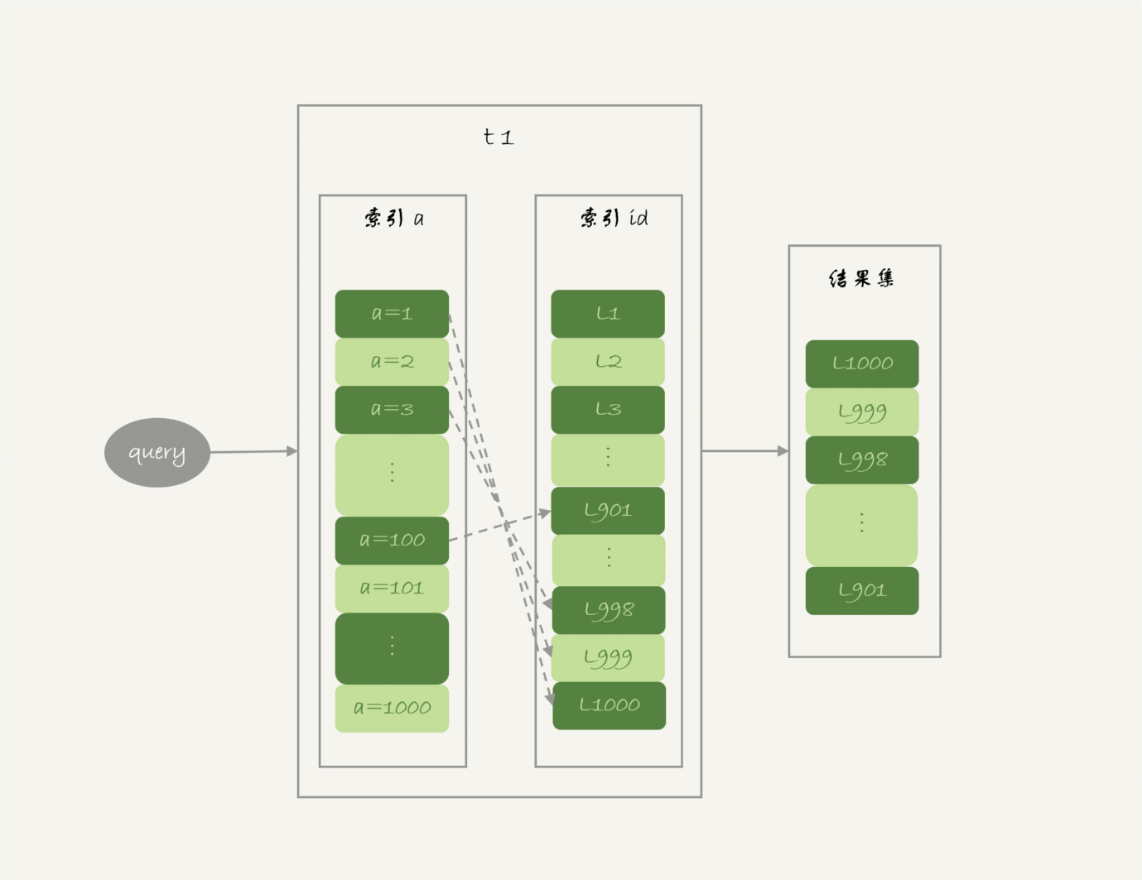
主键索引是一棵B+树,在这棵树上,每次只能根据一个主键id查到一行数据。因此,回表肯定是一行行搜索主键索引的,基本流程如图1所示。
|
||
|
||
|
||
|
||
图1 基本回表流程
|
||
|
||
如果随着a的值递增顺序查询的话,id的值就变成随机的,那么就会出现随机访问,性能相对较差。虽然“按行查”这个机制不能改,但是调整查询的顺序,还是能够加速的。
|
||
|
||
**因为大多数的数据都是按照主键递增顺序插入得到的,所以我们可以认为,如果按照主键的递增顺序查询的话,对磁盘的读比较接近顺序读,能够提升读性能。**
|
||
|
||
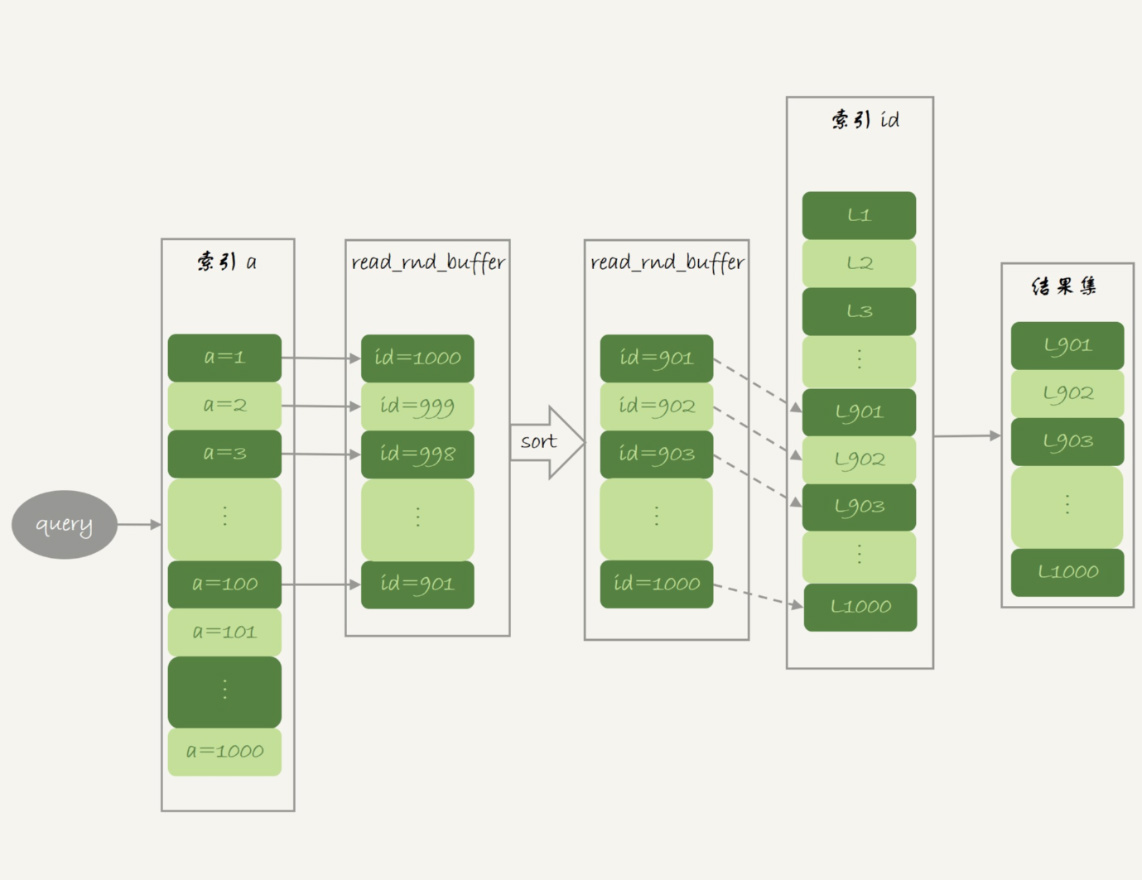
这,就是MRR优化的设计思路。此时,语句的执行流程变成了这样:
|
||
|
||
1. 根据索引a,定位到满足条件的记录,将id值放入read\_rnd\_buffer中;
|
||
|
||
2. 将read\_rnd\_buffer中的id进行递增排序;
|
||
|
||
3. 排序后的id数组,依次到主键id索引中查记录,并作为结果返回。
|
||
|
||
|
||
这里,read\_rnd\_buffer的大小是由read\_rnd\_buffer\_size参数控制的。如果步骤1中,read\_rnd\_buffer放满了,就会先执行完步骤2和3,然后清空read\_rnd\_buffer。之后继续找索引a的下个记录,并继续循环。
|
||
|
||
另外需要说明的是,如果你想要稳定地使用MRR优化的话,需要设置`set optimizer_switch="mrr_cost_based=off"`。(官方文档的说法,是现在的优化器策略,判断消耗的时候,会更倾向于不使用MRR,把mrr\_cost\_based设置为off,就是固定使用MRR了。)
|
||
|
||
下面两幅图就是使用了MRR优化后的执行流程和explain结果。
|
||
|
||
|
||
|
||
图2 MRR执行流程
|
||
|
||

|
||
|
||
图3 MRR执行流程的explain结果
|
||
|
||
从图3的explain结果中,我们可以看到Extra字段多了Using MRR,表示的是用上了MRR优化。而且,由于我们在read\_rnd\_buffer中按照id做了排序,所以最后得到的结果集也是按照主键id递增顺序的,也就是与图1结果集中行的顺序相反。
|
||
|
||
到这里,我们小结一下。
|
||
|
||
**MRR能够提升性能的核心**在于,这条查询语句在索引a上做的是一个范围查询(也就是说,这是一个多值查询),可以得到足够多的主键id。这样通过排序以后,再去主键索引查数据,才能体现出“顺序性”的优势。
|
||
|
||
# Batched Key Access
|
||
|
||
理解了MRR性能提升的原理,我们就能理解MySQL在5.6版本后开始引入的Batched Key Access(BKA)算法了。这个BKA算法,其实就是对NLJ算法的优化。
|
||
|
||
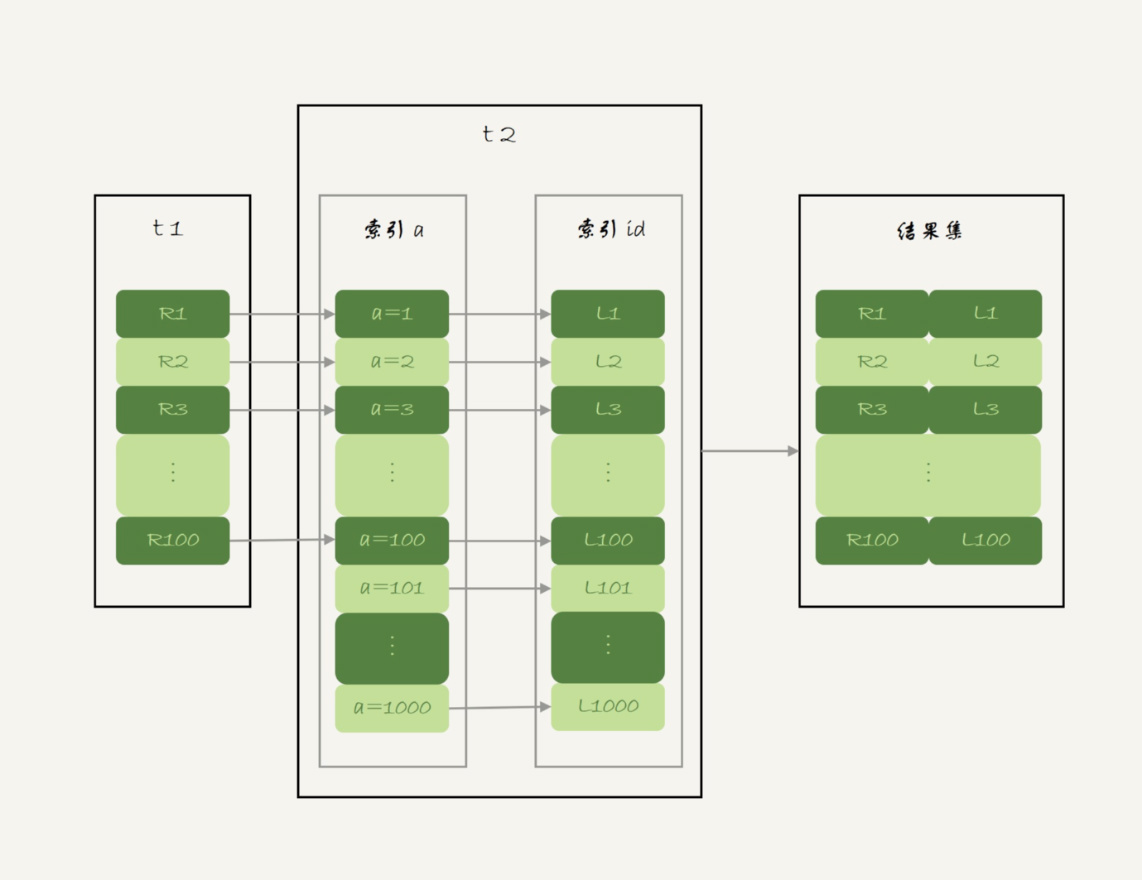
我们再来看看上一篇文章中用到的NLJ算法的流程图:
|
||
|
||
|
||
|
||
图4 Index Nested-Loop Join流程图
|
||
|
||
NLJ算法执行的逻辑是:从驱动表t1,一行行地取出a的值,再到被驱动表t2去做join。也就是说,对于表t2来说,每次都是匹配一个值。这时,MRR的优势就用不上了。
|
||
|
||
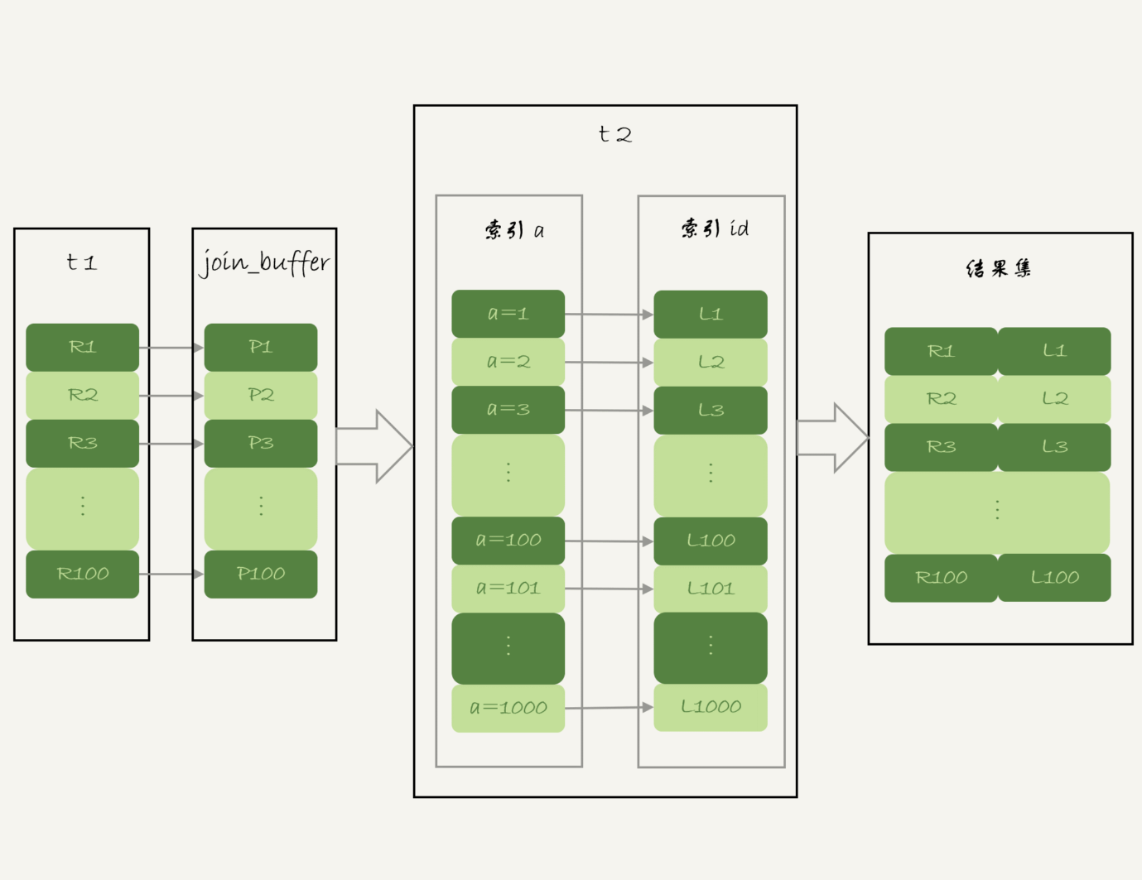
那怎么才能一次性地多传些值给表t2呢?方法就是,从表t1里一次性地多拿些行出来,一起传给表t2。
|
||
|
||
既然如此,我们就把表t1的数据取出来一部分,先放到一个临时内存。这个临时内存不是别人,就是join\_buffer。
|
||
|
||
通过上一篇文章,我们知道join\_buffer 在BNL算法里的作用,是暂存驱动表的数据。但是在NLJ算法里并没有用。那么,我们刚好就可以复用join\_buffer到BKA算法中。
|
||
|
||
如图5所示,是上面的NLJ算法优化后的BKA算法的流程。
|
||
|
||
|
||
|
||
图5 Batched Key Access流程
|
||
|
||
图中,我在join\_buffer中放入的数据是P1~P100,表示的是只会取查询需要的字段。当然,如果join buffer放不下P1~P100的所有数据,就会把这100行数据分成多段执行上图的流程。
|
||
|
||
那么,这个BKA算法到底要怎么启用呢?
|
||
|
||
如果要使用BKA优化算法的话,你需要在执行SQL语句之前,先设置
|
||
|
||
```
|
||
set optimizer_switch='mrr=on,mrr_cost_based=off,batched_key_access=on';
|
||
|
||
```
|
||
|
||
其中,前两个参数的作用是要启用MRR。这么做的原因是,BKA算法的优化要依赖于MRR。
|
||
|
||
# BNL算法的性能问题
|
||
|
||
说完了NLJ算法的优化,我们再来看BNL算法的优化。
|
||
|
||
我在上一篇文章末尾,给你留下的思考题是,使用Block Nested-Loop Join(BNL)算法时,可能会对被驱动表做多次扫描。如果这个被驱动表是一个大的冷数据表,除了会导致IO压力大以外,还会对系统有什么影响呢?
|
||
|
||
在[第33篇文章](https://time.geekbang.org/column/article/79407)中,我们说到InnoDB的LRU算法的时候提到,由于InnoDB对Bufffer Pool的LRU算法做了优化,即:第一次从磁盘读入内存的数据页,会先放在old区域。如果1秒之后这个数据页不再被访问了,就不会被移动到LRU链表头部,这样对Buffer Pool的命中率影响就不大。
|
||
|
||
但是,如果一个使用BNL算法的join语句,多次扫描一个冷表,而且这个语句执行时间超过1秒,就会在再次扫描冷表的时候,把冷表的数据页移到LRU链表头部。
|
||
|
||
这种情况对应的,是冷表的数据量小于整个Buffer Pool的3/8,能够完全放入old区域的情况。
|
||
|
||
如果这个冷表很大,就会出现另外一种情况:业务正常访问的数据页,没有机会进入young区域。
|
||
|
||
由于优化机制的存在,一个正常访问的数据页,要进入young区域,需要隔1秒后再次被访问到。但是,由于我们的join语句在循环读磁盘和淘汰内存页,进入old区域的数据页,很可能在1秒之内就被淘汰了。这样,就会导致这个MySQL实例的Buffer Pool在这段时间内,young区域的数据页没有被合理地淘汰。
|
||
|
||
也就是说,这两种情况都会影响Buffer Pool的正常运作。
|
||
|
||
**大表join操作虽然对IO有影响,但是在语句执行结束后,对IO的影响也就结束了。但是,对Buffer Pool的影响就是持续性的,需要依靠后续的查询请求慢慢恢复内存命中率。**
|
||
|
||
为了减少这种影响,你可以考虑增大join\_buffer\_size的值,减少对被驱动表的扫描次数。
|
||
|
||
也就是说,BNL算法对系统的影响主要包括三个方面:
|
||
|
||
1. 可能会多次扫描被驱动表,占用磁盘IO资源;
|
||
|
||
2. 判断join条件需要执行M\*N次对比(M、N分别是两张表的行数),如果是大表就会占用非常多的CPU资源;
|
||
|
||
3. 可能会导致Buffer Pool的热数据被淘汰,影响内存命中率。
|
||
|
||
|
||
我们执行语句之前,需要通过理论分析和查看explain结果的方式,确认是否要使用BNL算法。如果确认优化器会使用BNL算法,就需要做优化。优化的常见做法是,给被驱动表的join字段加上索引,把BNL算法转成BKA算法。
|
||
|
||
接下来,我们就具体看看,这个优化怎么做?
|
||
|
||
# BNL转BKA
|
||
|
||
一些情况下,我们可以直接在被驱动表上建索引,这时就可以直接转成BKA算法了。
|
||
|
||
但是,有时候你确实会碰到一些不适合在被驱动表上建索引的情况。比如下面这个语句:
|
||
|
||
```
|
||
select * from t1 join t2 on (t1.b=t2.b) where t2.b>=1 and t2.b<=2000;
|
||
|
||
```
|
||
|
||
我们在文章开始的时候,在表t2中插入了100万行数据,但是经过where条件过滤后,需要参与join的只有2000行数据。如果这条语句同时是一个低频的SQL语句,那么再为这个语句在表t2的字段b上创建一个索引就很浪费了。
|
||
|
||
但是,如果使用BNL算法来join的话,这个语句的执行流程是这样的:
|
||
|
||
1. 把表t1的所有字段取出来,存入join\_buffer中。这个表只有1000行,join\_buffer\_size默认值是256k,可以完全存入。
|
||
|
||
2. 扫描表t2,取出每一行数据跟join\_buffer中的数据进行对比,
|
||
|
||
* 如果不满足t1.b=t2.b,则跳过;
|
||
* 如果满足t1.b=t2.b, 再判断其他条件,也就是是否满足t2.b处于\[1,2000\]的条件,如果是,就作为结果集的一部分返回,否则跳过。
|
||
|
||
我在上一篇文章中说过,对于表t2的每一行,判断join是否满足的时候,都需要遍历join\_buffer中的所有行。因此判断等值条件的次数是1000\*100万=10亿次,这个判断的工作量很大。
|
||
|
||

|
||
|
||
图6 explain结果
|
||
|
||
|
||
|
||
图7 语句执行时间
|
||
|
||
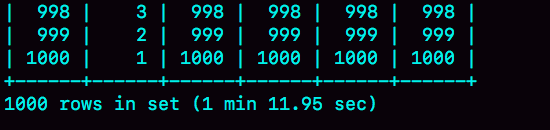
可以看到,explain结果里Extra字段显示使用了BNL算法。在我的测试环境里,这条语句需要执行1分11秒。
|
||
|
||
在表t2的字段b上创建索引会浪费资源,但是不创建索引的话这个语句的等值条件要判断10亿次,想想也是浪费。那么,有没有两全其美的办法呢?
|
||
|
||
这时候,我们可以考虑使用临时表。使用临时表的大致思路是:
|
||
|
||
1. 把表t2中满足条件的数据放在临时表tmp\_t中;
|
||
|
||
2. 为了让join使用BKA算法,给临时表tmp\_t的字段b加上索引;
|
||
|
||
3. 让表t1和tmp\_t做join操作。
|
||
|
||
|
||
此时,对应的SQL语句的写法如下:
|
||
|
||
```
|
||
create temporary table temp_t(id int primary key, a int, b int, index(b))engine=innodb;
|
||
insert into temp_t select * from t2 where b>=1 and b<=2000;
|
||
select * from t1 join temp_t on (t1.b=temp_t.b);
|
||
|
||
```
|
||
|
||
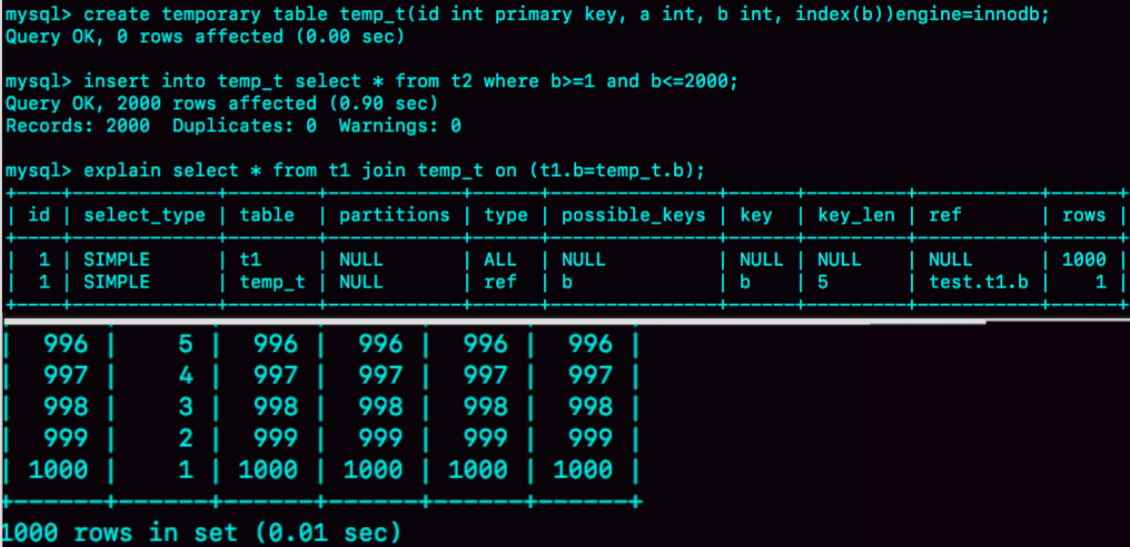
图8就是这个语句序列的执行效果。
|
||
|
||
|
||
|
||
图8 使用临时表的执行效果
|
||
|
||
可以看到,整个过程3个语句执行时间的总和还不到1秒,相比于前面的1分11秒,性能得到了大幅提升。接下来,我们一起看一下这个过程的消耗:
|
||
|
||
1. 执行insert语句构造temp\_t表并插入数据的过程中,对表t2做了全表扫描,这里扫描行数是100万。
|
||
|
||
2. 之后的join语句,扫描表t1,这里的扫描行数是1000;join比较过程中,做了1000次带索引的查询。相比于优化前的join语句需要做10亿次条件判断来说,这个优化效果还是很明显的。
|
||
|
||
|
||
总体来看,不论是在原表上加索引,还是用有索引的临时表,我们的思路都是让join语句能够用上被驱动表上的索引,来触发BKA算法,提升查询性能。
|
||
|
||
# 扩展-hash join
|
||
|
||
看到这里你可能发现了,其实上面计算10亿次那个操作,看上去有点儿傻。如果join\_buffer里面维护的不是一个无序数组,而是一个哈希表的话,那么就不是10亿次判断,而是100万次hash查找。这样的话,整条语句的执行速度就快多了吧?
|
||
|
||
确实如此。
|
||
|
||
这,也正是MySQL的优化器和执行器一直被诟病的一个原因:不支持哈希join。并且,MySQL官方的roadmap,也是迟迟没有把这个优化排上议程。
|
||
|
||
实际上,这个优化思路,我们可以自己实现在业务端。实现流程大致如下:
|
||
|
||
1. `select * from t1;`取得表t1的全部1000行数据,在业务端存入一个hash结构,比如C++里的set、PHP的数组这样的数据结构。
|
||
|
||
2. `select * from t2 where b>=1 and b<=2000;` 获取表t2中满足条件的2000行数据。
|
||
|
||
3. 把这2000行数据,一行一行地取到业务端,到hash结构的数据表中寻找匹配的数据。满足匹配的条件的这行数据,就作为结果集的一行。
|
||
|
||
|
||
理论上,这个过程会比临时表方案的执行速度还要快一些。如果你感兴趣的话,可以自己验证一下。
|
||
|
||
# 小结
|
||
|
||
今天,我和你分享了Index Nested-Loop Join(NLJ)和Block Nested-Loop Join(BNL)的优化方法。
|
||
|
||
在这些优化方法中:
|
||
|
||
1. BKA优化是MySQL已经内置支持的,建议你默认使用;
|
||
|
||
2. BNL算法效率低,建议你都尽量转成BKA算法。优化的方向就是给被驱动表的关联字段加上索引;
|
||
|
||
3. 基于临时表的改进方案,对于能够提前过滤出小数据的join语句来说,效果还是很好的;
|
||
|
||
4. MySQL目前的版本还不支持hash join,但你可以配合应用端自己模拟出来,理论上效果要好于临时表的方案。
|
||
|
||
|
||
最后,我给你留下一道思考题吧。
|
||
|
||
我们在讲join语句的这两篇文章中,都只涉及到了两个表的join。那么,现在有一个三个表join的需求,假设这三个表的表结构如下:
|
||
|
||
```
|
||
CREATE TABLE `t1` (
|
||
`id` int(11) NOT NULL,
|
||
`a` int(11) DEFAULT NULL,
|
||
`b` int(11) DEFAULT NULL,
|
||
`c` int(11) DEFAULT NULL,
|
||
PRIMARY KEY (`id`)
|
||
) ENGINE=InnoDB;
|
||
|
||
create table t2 like t1;
|
||
create table t3 like t2;
|
||
insert into ... //初始化三张表的数据
|
||
|
||
```
|
||
|
||
语句的需求实现如下的join逻辑:
|
||
|
||
```
|
||
select * from t1 join t2 on(t1.a=t2.a) join t3 on (t2.b=t3.b) where t1.c>=X and t2.c>=Y and t3.c>=Z;
|
||
|
||
```
|
||
|
||
现在为了得到最快的执行速度,如果让你来设计表t1、t2、t3上的索引,来支持这个join语句,你会加哪些索引呢?
|
||
|
||
同时,如果我希望你用straight\_join来重写这个语句,配合你创建的索引,你就需要安排连接顺序,你主要考虑的因素是什么呢?
|
||
|
||
你可以把你的方案和分析写在留言区,我会在下一篇文章的末尾和你讨论这个问题。感谢你的收听,也欢迎你把这篇文章分享给更多的朋友一起阅读。
|
||
|
||
# 上期问题时间
|
||
|
||
我在上篇文章最后留给你的问题,已经在本篇文章中解答了。
|
||
|
||
这里我再根据评论区留言的情况,简单总结下。根据数据量的大小,有这么两种情况:
|
||
|
||
* @长杰 和 @老杨同志 提到了数据量小于old区域内存的情况;
|
||
* @Zzz 同学,很认真地看了其他同学的评论,并且提了一个很深的问题。对被驱动表数据量大于Buffer Pool的场景,做了很细致的推演和分析。
|
||
|
||
给这些同学点赞,非常好的思考和讨论。
|
||
|